Datathon Nedir? Veriyle Yarışmanın Kuralları
Değerlendirme ölçüsünü anlamak, sıralama tablosu tuzağı, veri sızıntısı, değişken üretmek ve düzenleyen için asıl sorun olan veri temini.
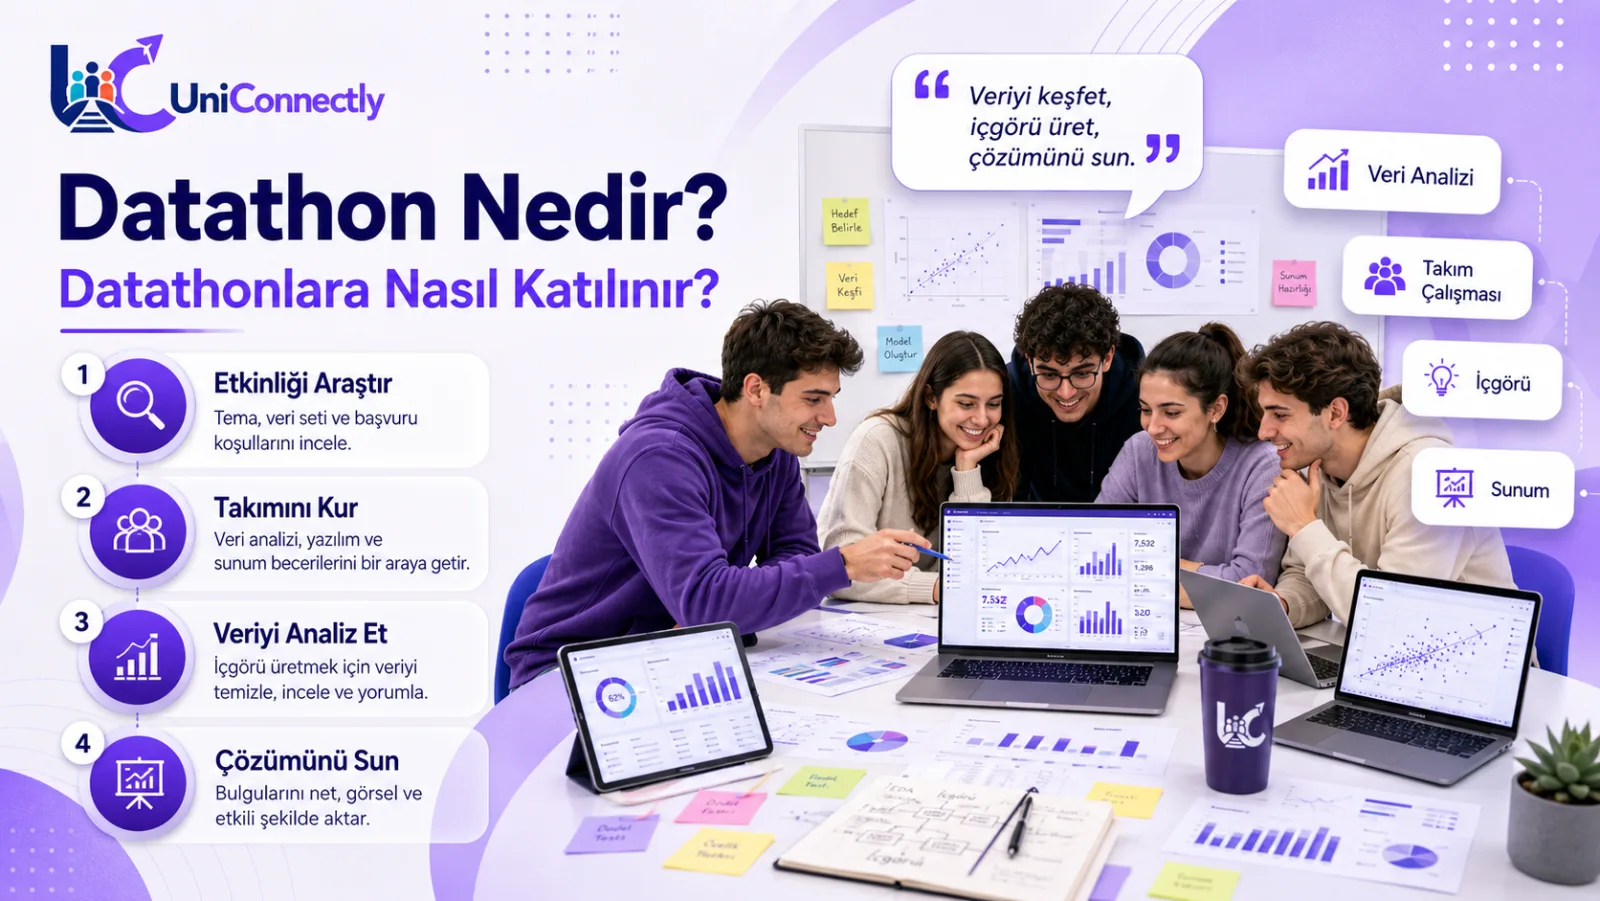
Datathon nedir
Datathon, katılımcılara bir veri kümesi verilip belirli bir süre içinde bu veriden anlamlı çıkarım ya da tahmin modeli üretmelerinin istendiği yarışma formatı. Adı data ve marathon kelimelerinden geliyor.
Hackathondan ayrıldığı nokta net: orada ürün geliştiriliyor, burada veri üzerinde çalışılıyor. Çıktı bir uygulama değil; bir model, bir analiz raporu ya da bir tahmin dosyası.
İki ana biçimi var ve hangisine katıldığınız hazırlığı tamamen değiştiriyor:
- Yarışma tipi. Ölçülebilir bir hedef var (tahmin doğruluğu gibi), sıralama tablosu otomatik güncelleniyor. Kazanan skorla belirleniyor.
- Açık uçlu tip. Veri veriliyor, "bundan ne çıkarırsanız" deniyor. Jüri bulguların anlamlılığına ve anlatımına bakıyor.
Nasıl işler
| Aşama | Ne olur |
|---|---|
| Veri ve problem paylaşımı | Veri kümesi, hedef değişken, değerlendirme ölçüsü |
| Keşif | Veriye bakma, eksik ve tutarsızlıkları görme |
| Temizleme | Eksik değer, aykırı gözlem, biçim düzeltme |
| Değişken üretme | Ham veriden yeni sütunlar çıkarma |
| Modelleme | Model kurma ve karşılaştırma |
| Gönderim | Sonuç dosyasının yüklenmesi |
| Sunum | Yaklaşımın anlatılması |
Deneyimli takımların zamanının büyük kısmı ortadaki iki satırda geçiyor. Yeni başlayanlar ise doğrudan modele atlıyor ve kirli veriyle kurulan model, temiz veriyle kurulan basit bir modelin gerisinde kalıyor.
Değerlendirme ölçüsü
Yarışma tipi datathonlarda tek bir sayı kazananı belirliyor ve o sayının ne olduğu baştan açıklanıyor. Sık kullanılan ölçüler:
| Ölçü | Ne zaman kullanılır |
|---|---|
| Doğruluk | Sınıflar dengeliyse |
| F1 | Sınıflar dengesizse |
| RMSE / MAE | Sayısal tahminlerde |
| AUC | Sıralama kalitesi önemliyse |
Bu tablonun pratik önemi şu: ölçüyü bilmeden model seçilmiyor. Dengesiz bir veri kümesinde doğruluğu yüksek görünen bir model, F1 ile ölçüldüğünde çok kötü çıkabiliyor. Yarışmanın ölçüsü neyse, model o ölçüye göre iyileştirilmeli.
Sıralama tablosu tuzağı
Yarışma tipi etkinliklerde katılımcıların ekranında canlı bir sıralama tablosu duruyor ve buna bakarak model geliştirmek en yaygın hata.
Sebebi teknik: sıralama tablosu, verinin bir bölümü üzerinden hesaplanıyor. Sürekli o bölüme göre iyileştirme yapmak, modeli o veriye ezberletiyor. Etkinlik sonunda gizli veri üzerinden hesaplanan asıl sıralama açıklandığında, tabloda üstlerde görünen takımlar aşağı düşüyor.
Korunma yolu basit: kendi elinizde bir doğrulama kümesi ayırın ve kararlarınızı sıralama tablosuna değil ona göre verin. Tabloya günde birkaç kez bakmak yeterli.
Veriye önce bakmak
Datathonda en yüksek getirili saat, ilk saat. Modele başlamadan önce şu soruların cevabı bilinmeli:
- Kaç satır, kaç sütun var?
- Hangi sütunda ne kadar eksik değer var?
- Hedef değişkenin dağılımı nasıl, dengeli mi?
- Tarih alanları hangi aralığı kapsıyor?
- Aynı kayıt birden fazla kez var mı?
- Veri nasıl toplanmış, sızıntı ihtimali var mı?
Son madde çoğu takımın kaçırdığı ve en çok puan kaybettiren konu. Veri sızıntısı, tahmin edilmeye çalışılan bilginin dolaylı olarak girdi sütunlarında bulunması demek. Sızıntılı bir sütunla kurulan model eğitimde mükemmel görünüyor, gerçek veride çöküyor.
Değişken üretmek
Datathonlarda sıralamayı en çok değiştiren şey model seçimi değil, ham veriden yeni sütunlar çıkarmak. Aynı veriyle çalışan iki takım arasındaki fark genellikle burada oluşuyor.
Yaygın ve çoğu problemde işe yarayan yaklaşımlar:
- Tarihten parça çıkarmak. Bir zaman damgasından gün, ay, haftanın günü, hafta sonu mu, tatil mi bilgisi türetiliyor. Ham tarih tek başına modele az şey söylüyor.
- Toplulaştırma. Kişi ya da ürün başına ortalama, toplam, en büyük ve en küçük değerler.
- Oran üretmek. İki sütunun birbirine oranı, ikisinin ayrı ayrı hâlinden daha bilgilendirici olabiliyor.
- Metinden uzunluk ve sayım. Serbest metin sütunlarında karakter sayısı, kelime sayısı gibi basit ölçüler bile sinyal taşıyor.
- Kategorileri birleştirmek. Yüzlerce nadir kategoriyi "diğer" altında toplamak, modeli sadeleştiriyor.
Her yeni sütun ölçülmeli: doğrulama kümesindeki skoru iyileştirmiyorsa çıkarılmalı. Sütun sayısını artırmak tek başına iyileşme getirmiyor, aksine ezberi kolaylaştırıyor.
Anlatım
Açık uçlu datathonlarda kazandıran şey en karmaşık model değil, en anlaşılır bulgu. Jüri, teknik ayrıntıdan çok "bu veriden ne öğrendik" sorusunun cevabını arıyor.
İşleyen sunum yapısı:
- Veride ne var — kısa tanıtım.
- Ne sorduk — hangi soruyu cevaplamaya çalıştık.
- Ne bulduk — iki üç net bulgu, grafikle.
- Ne yaptık — yöntem, kısa.
- Ne işe yarar — bulgunun pratik karşılığı.
Grafiklerde tek kural: her grafik bir cümleyi kanıtlamalı. Anlatılan bir şeye hizmet etmeyen grafik sunumdan çıkarılmalı.
Öğrenci için değeri
Datathon, veri alanına girmek isteyen öğrenci için en somut giriş kapılarından biri:
- Gerçek veriyle çalışma. Ders projelerindeki temiz veri kümeleri, gerçek hayatı yansıtmıyor.
- Portföy. Not defteri dosyası ve yaklaşım açıklaması, doğrudan paylaşılabilir bir çıktı.
- Ölçülebilir sonuç. "Şu yarışmada şu sıradaydım" cümlesi, mülakatta doğrulanabilir bir referans.
- Sektör teması. Bankacılık, perakende, sağlık gibi alanlardan gerçek problemlerle tanışma.
Derece almasanız bile katıldığınız yarışmanın kod deposunu düzenli bırakmak, katılım belgesinden daha değerli.
Kampüste datathon düzenlemek
Düzenleyen taraf için asıl zorluk salon değil veri. Üç seçenek var:
- Açık veri kullanmak. Kamu kurumlarının ve uluslararası kaynakların açık veri kümeleri ücretsiz ve izin sorunu çıkarmıyor.
- Sponsordan veri almak. En değerli seçenek ama en yavaşı: şirketin veriyi anonimleştirmesi ve hukuk onayı alması gerekiyor, bu haftalar sürebiliyor.
- Sentetik veri üretmek. Gerçekçiliği düşük ama tamamen kontrol edilebilir.
İkinci seçenekte kişisel veri konusu kritik: veri anonim değilse etkinlik yapılamaz. "İsimleri sildik" anonimleştirme değil — birleştirildiğinde kişiyi tanımlayabilen sütunlar da temizlenmeli.
Değerlendirme altyapısı da planlanmalı: sıralama tablosu kuracaksanız gönderim ve puanlama otomatik olmalı, elle puanlama on takımdan sonra yürümüyor.
Sık sorulanlar
Hangi araçları bilmek gerekir? Temel düzeyde Python ya da R, veri işleme kütüphaneleri ve basit modelleme yeterli. Derin öğrenme çoğu öğrenci datathonunda gerekmiyor.
Tek başına katılınır mı? Katılınır ama zaman baskısı yüksek. Temizleme, modelleme ve sunumu tek kişinin yürütmesi zor.
Basit model yeterli mi? Çoğu zaman evet. İyi hazırlanmış veriyle kurulan basit bir model, kötü hazırlanmış veriyle kurulan karmaşık modeli düzenli olarak geçiyor.
Özet
Datathon, veriden çıkarım üreten bir yarışma formatı. Kazandıran şey model karmaşıklığı değil; ölçüyü doğru anlamak, veriye modelden önce bakmak, sızıntıyı fark etmek ve kendi doğrulama kümesiyle karar vermek. Düzenleyen topluluk içinse ilk çözülmesi gereken sorun veri: açık veri en hızlısı, sponsor verisi en değerlisi ama anonimleştirme olmadan hiçbiri kullanılamaz.